 雷科技








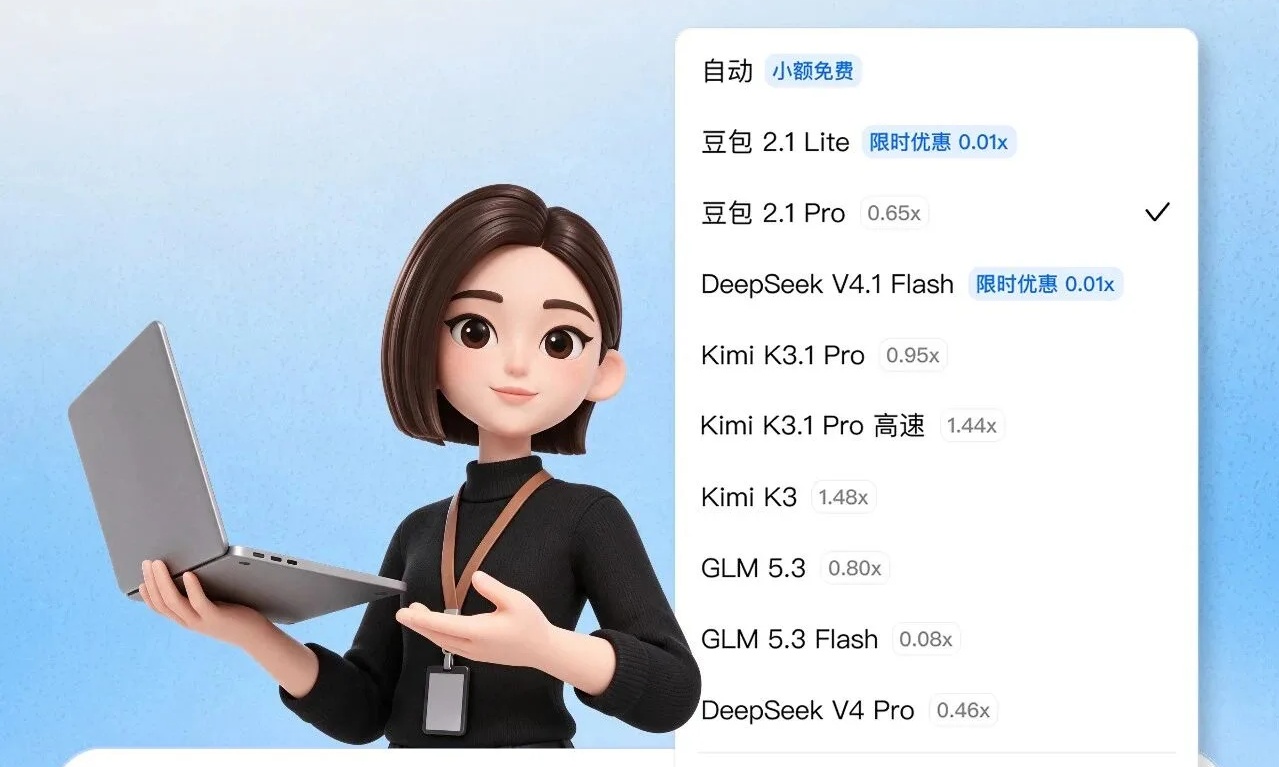

11月12日消息,豆包工作今日正式接入了Kimi、GLM、DeepSeek三款第三方大模型,加上原本的两款自研模型,直接凑齐了一个五款模型的AI工具箱。
对于天天靠AI干活的打工人来说,这是一个很实在的变化。
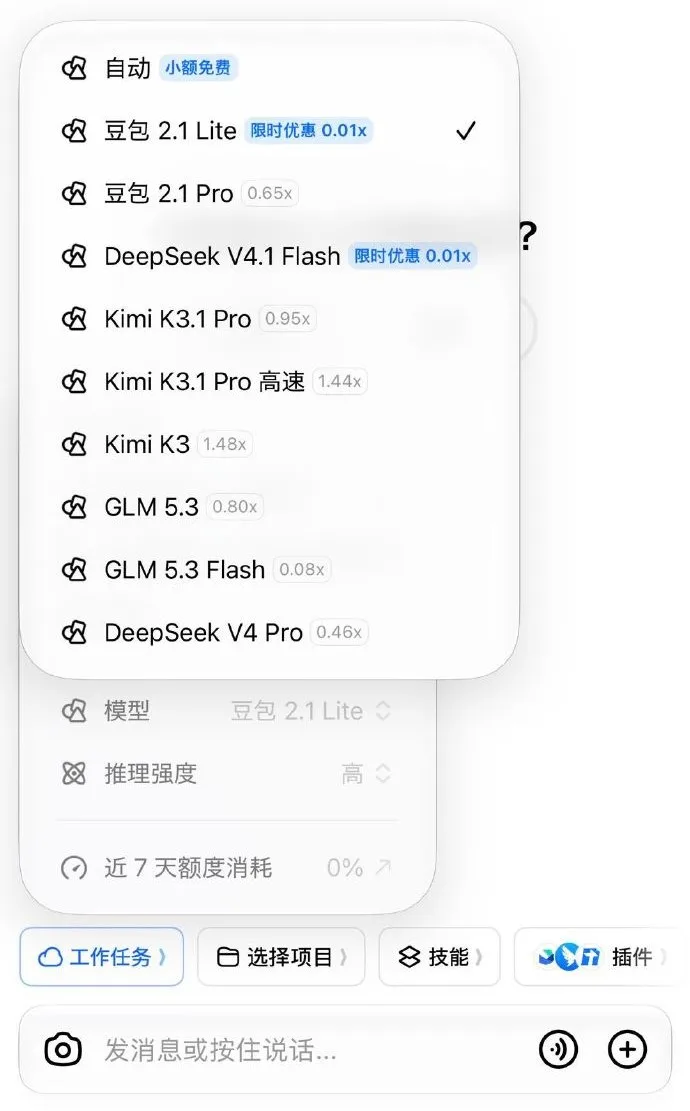
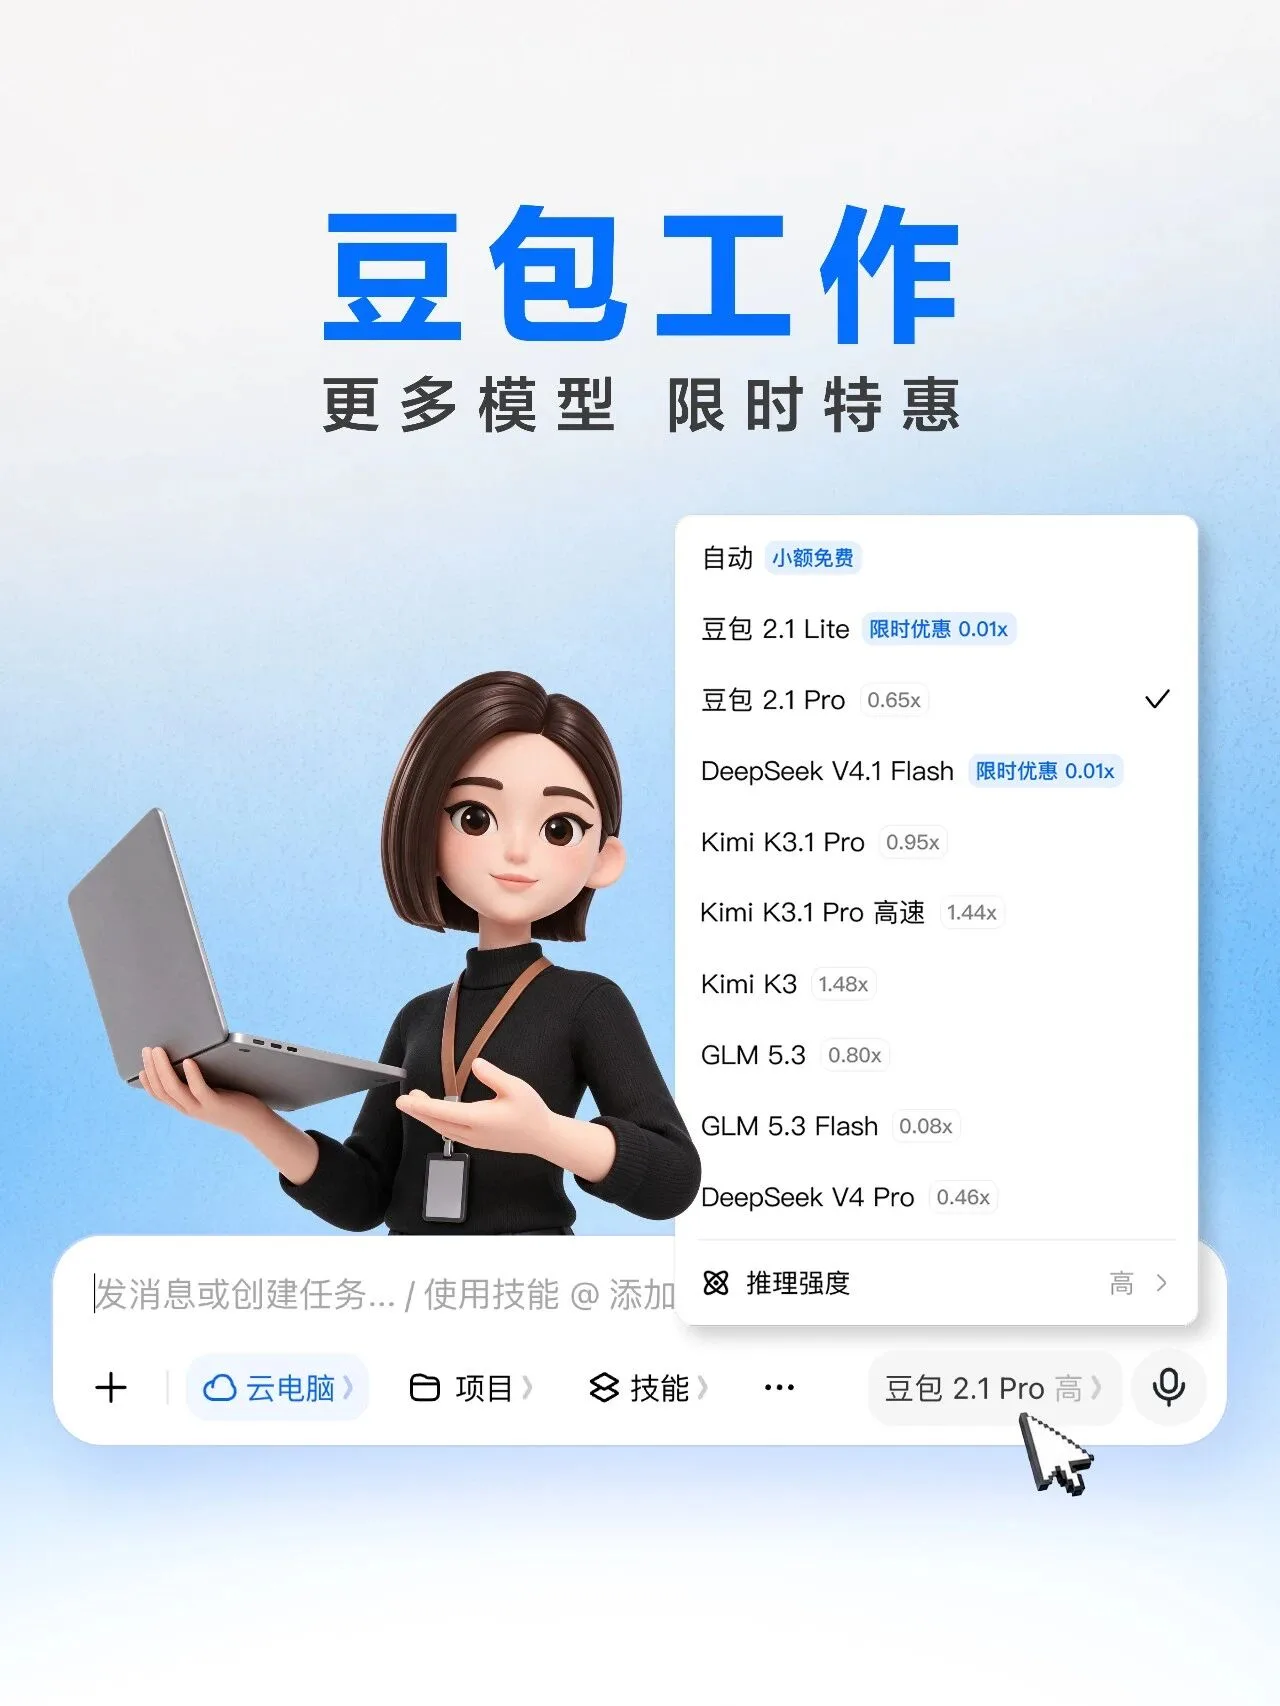
今日豆包工作完成了一轮产品更新,在原有豆包2.1 Lite、豆包2.1 Pro两款自研模型的基础上,新增了Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash三款第三方模型。
早在10月29日,团队订阅版和企业订阅版就已经用上这些第三方模型了,这次是面向更广泛的用户开放,算是正式全面铺开。
(图源:微博)
据小雷研究发现,这三款新模型不是随便凑数的,而是各自精准补上了一块能力短板。
先说第一款的Kimi K3.1 Pro,他主打的是百万字级超长上下文。
这个能力有多实用?比如说你手里攥着十几份行业报告、几十页产品文档。想一次性梳理清楚,普通模型根本装不下,得分段投喂、反复拼接,折腾半天还容易前后逻辑对不上。
Kimi的长上下文就是干这个的,整份报告、多份资料一股脑丢进去,一次性就能梳理出重点,省了大量拆分整合的时间。
然后第二款是GLM 5.3,侧重中文语言理解与生成。
咱们日常办公大部分场景还是中文写作、材料整理、内容润色这类活儿,GLM在中文语境下的表现向来有口碑。处理常规的写稿、改稿、整理纪要这类任务,适配度很高,产出的内容也更符合中文表达习惯。
第三款是DeepSeek V4.1 Flash,核心卖点是高响应速度和高性价比。
日常那些轻量任务,比如改个句子、列个提纲、查个知识点,不一定非要用顶配模型,快、准、省才是硬道理。这款就是定位轻量日常任务,响应快、消耗低,用来处理高频小活儿最合适。
这么一组合,加上原本的两款自研模型,豆包工作基本就形成了高中低三档,不同需求都能找到对应的模型。
(图源:豆包微博)
小雷哔哔(ID:xiaoleibbb)发现这次有个更实在的改动,上线了倍率标注机制。
官方直接在模型选择页面标清楚了每款模型的额度消耗倍率,倍率越低,完成同一个任务消耗的平台额度就越少,简单小额任务还是免费的。
小雷已经看到有网友试了日常办公场景,整理资料、反复改文稿、列方案大纲,纷纷称赞额度消耗特别温和。
不用再纠结每一次提问值不值得,心理不再有负担。天天靠AI分担工作量的打工人,这种额度宽裕的感觉真的太舒服。
而且还有限时优惠,工作日和节假日的指定时段使用参与活动的模型,可以享受额度优惠。
豆包2.1 Lite和DeepSeek V4.1 Flash这两款已经直接下调了倍率,对日常重度使用的人来说,积少成多能省不少。
(图源:微博)
小雷哔哔(ID:xiaoleibbb)觉得,目前还没出现一款完全全能的模型。
有的模型强在逻辑推理,有的擅长产出文案,有的处理长文本厉害,有的速度快性价比高。单靠一款模型打天下,总会有各种各样的小麻烦。
以前想兼顾就得开好几个账号、切好几个网页,数据传过来传过去,麻烦不说还容易乱。
现在豆包工作把多款模型整合在一个平台里,碰到难活随时切换,按自己的需求挑着用,灵活度一下就上来了。
不用来回切换不同工具,一个入口就能按需选模型处理任务,对经常要用AI干活的人来说,省心不是一点点。
最后问问大家,你们平时用AI办公最看重什么能力?欢迎在评论区聊聊。