 雷科技









今年看到不少员工烧Token烧到账单失控的新闻,米哈游《崩铁》制作人蒋大卫此前在一场校园宣讲中就曾分享:几十个Agent连续协作13个小时,最终烧掉了200万元的Token。看似偶发,实际反应的是企业普遍存在的“AI浪费”现象,TechCrunch报道称,Uber在2026年4月之前就已经用光了全年AI coding预算。
模型成本越来越低,然而当AI真正大规模进入到生产级场景时,Token反而正在成为一类难以预测、管控和解释的成本变量。于是设置Token限额成了越来越多企业的共同选择。然而这导致员工用AI被迫切换到“能省则省”的模式,反过来又制约了AI的落地进程。对企业来说,是时候搭建一套科学长效的AI体系了,而最关键的思路就是要“由省到管”。管,不是为了省Token,而是要让每个Token花在对的地方,该用的一个不省、不该用的一点不浪费。
企业Token账单爆表,只靠「省」解决不了真问题
在Token账单爆表后,企业开始冷静下来了:AI必须要用,但更要科学用。
怎么科学地用?今天很多大厂的普遍实践是“单一限额”,比如有媒体报道称,9月起JPMorgan开始对部分员工使用Claude实施更严格的成本控制,部分员工每月Claude使用额度被设置为2000美元,国内外很多企业都采取类似模式,将员工的Token额度从无上限/高额度,一刀切调到了低额度,甚至要求部分岗位员工“自带Token上班”。
这并不难理解,任何一个CFO看到一张爆表的AI账单,第一反应都是先把水龙头拧紧。问题在于,静态限额只能解决“用了多少”的问题,却未能回答“为什么用”、“用得值不值”和“应该让谁用什么模型”的问题。
一方面,AI单位成本在下降,企业AI用量指数级上涨,今天的限额明天就不再适用;另一方面,Token需求是弹性的,不同岗位、不同场景、不同项目甚至不同时期,都有不同的AI需求。
如果企业只是简单地给每个人设一个固定Token额度,虽说账单可控,但却很可能把AI应用重新拉回传统IT管理的老路:为了控制风险而限制创新。以“限额”为核心的Token管控机制会让员工过度关注“成本与用量”,而忽视AI的价值错配问题。
麦肯锡2025年全球AI调研显示,88%的企业已在至少一个业务职能常态化使用AI,但真正实现规模化落地、拿到可衡量业务收益的仅约6%。智能供给与企业落地之间的关键鸿沟就在效率和场景上,员工没有将AI用在业务流程和真实场景中,大多停留在邮件、PPT、沟通等生产经营外围场景。
将AI全面推进到真实生产场景,发挥业务价值,依然迫在眉睫。因此当下企业需要做的绝不应该是“省Token”,这一思路默认Token是需要压缩的成本,却没有将其和业务价值连起来。真正成熟的企业AI体系应该是在保障Token供应充足的同时,“精准滴灌”一般地让每一个Token都花在刀刃上,让Token成本和业务结果形成可追踪的关系。
如何做到呢?答案在于:“管”:企业需要一个全新的Token供应与管控体系。静态一刀切设置限额本质是“堵”,只卡总量和个人用量,未能回答值与不值。不是说不能设限,而是要看Token限制是死的还是活的,只有科学地将Token供应给“管”起来,动态计量、面向业务灵活适配、构建模型路由,让额度跟着价值走,才能让企业实现“加速AI落地到生产场景+绝不浪费一个Token”的既要又要。
其实这个逻辑很好理解:
过去,企业管控信息化成本时可基于预测的业务变化定预算,云计算允许弹性扩容,但在AI时代,基于预测和静态预算的旧成本管控方法,已经整体失效。一个Agent可能只是因为多了一层上下文、多调用几次工具、多跑几轮推理,就让成本产生数量级变化;同样一个任务,用大/小模型、新/旧模型、旗舰/普惠模型、本地/云端模型做,成本不同,效果也不同;同一个模型在不同推理架构、不同KV Cache策略、不同上下文长度、不同部署模式下,成本也有天壤之别。
企业真正需要的是一整套能适应变化的“Token生产—分配—消费—评价”系统,也就是要回答AI进入工业化阶段后的核心问题:如何打破Token黑盒?
打破Token黑盒,企业必须要建立自己的Token工厂
先看国外的解法。
微软商业CEO Judson Althoff曾公开强调,企业AI需要model diversity,不应该把所有工作押在单一模型上,而是根据不同任务匹配不同模型,让不同模型承担不同角色和经济成本。
这其实已经很接近企业私有Token工厂的基本逻辑:不再是买一堆模型额度回来用,也不是用云端Token来应急,而是要将AI基础设施建设成一个可持续生产Token、调度Token、管理Token的工厂,其中有多个Token生产线保障公司业务源源不断的AI供给。
这正是超聚变旗下的FusionOne AI提出Token Factory思路的价值所在:不是卖模型或者做模型中转站让企业“用更便宜的Token”,也不是给企业一个Token额度管理后台,而是将算力、模型、推理、Token治理、Agent运行和行业应用放进同一个生产体系里,把Token的生产、分配、消费和评价当成一盘棋全局管理,让企业能根据自身真实业务负载建设一套AI生产基础设施。
有人要问,如果只是单一地弹性管控Token用量,用云上Token不香吗?事实上,很多云计算巨头都已修正定位为“Token超级工厂”,为什么企业还要自建?
最直接的原因是AI主权:企业只有自建Token工厂,才能根本上实现“自己的AI自己管”:数据可隔离、模型可本地、Token可管控,一切都在自己的边界内。
即便是在AI前的云计算时代,企业云服务账单“失控”的新闻也不在少数,比如Dropbox早期大量使用AWS S3存储,然而随着用户和数据规模快速增长,Dropbox发现:持续把大量数据放在云上的经济性开始变差,2015年开始Dropbox把大量用户数据迁移到自己的基础设施,结果两年节省了约7460万美元运营成本。
不是说今天企业都需要自己训练大模型,或者自建GPU数据中心,而是必须要有自己的AI资源调度和生产体系,唯有此才能实现真正的精细化管控。
自建的另一层好处是可实现更灵活的模型路由。
传统企业软件的更新周期是年,模型的周,这意味着企业今天围绕某个模型搭出来的系统,几个月之后可能就需要重新切换。如果AI基础设施直接和某一家模型厂商深度绑定,那么每一次模型迭代都可能变成一次架构调整,AI升级就会被供应商的模型节奏牵着走。微软商业CEO Judson Althoff曾分享,当初把Copilot绑定在OpenAI模型上,是一个错误。
谁都不知道明天会出现什么更强的,或者更具性价比的新模型,企业需要AI升级的可持续性,不只是捆绑在任何一个模型上,而是必须建立“多模型组合”再根据业务、场景、成本等因素“路由”到最适合模型,实现全局最优。虽然很多云平台都聚合了多模型,但聚合哪些、何时接入新模型以及模型成本等等都是平台决策,部分平台因竞争等原因会将某些模型降权或排除,企业用云Token自身话语权反而不高。
此外自建Token工厂有显著的规模优势。当企业AI进入生产级时,按Token付费的API成本会随用量线性增长,而自建Token基础设施可通过精确调度GPU利用率、批处理和模型路由摊薄单位成本。更重要的是,开放权重模型的成本优势正在扩大,企业将其部署在Token工厂大量用可进一步压成本。
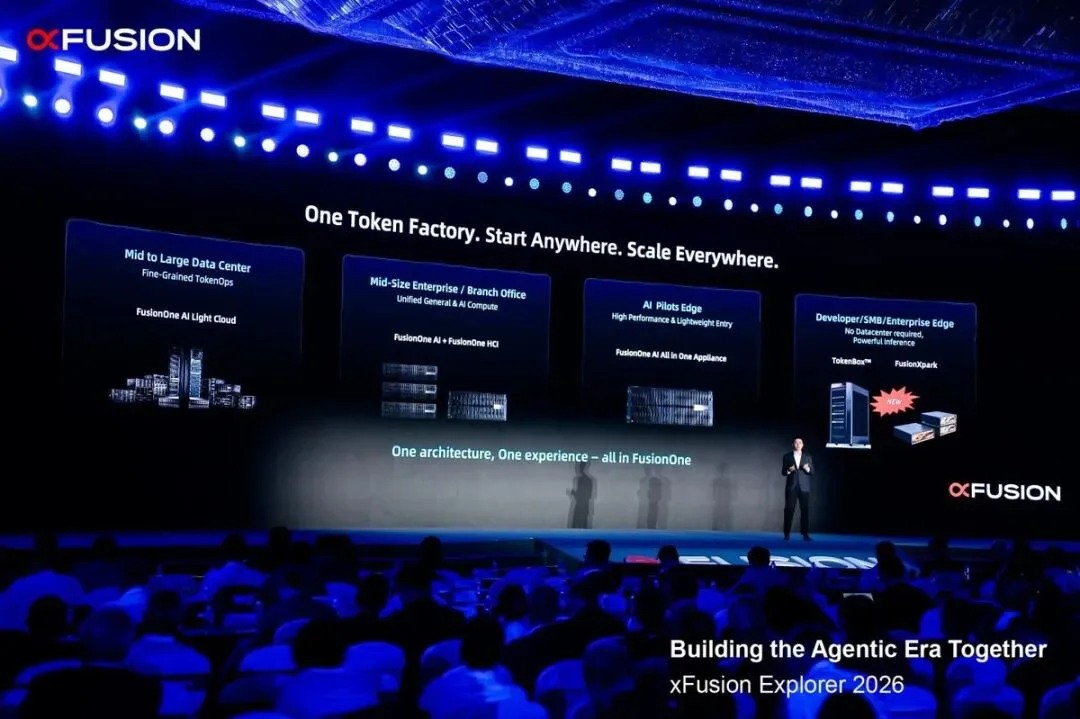
所以未来企业的普遍做法可能是:高频、标准化、数据敏感任务交给本地模型,少量复杂任务交给云端前沿闭源模型,形成“本地大规模生产+云端高端补充”的Token工厂,这正是超聚变FusionOne AI致力于交付给企业的解决方案。
FusionOne AI的底层是负责Token供给的算力,让企业可以快速构建Token工厂。它适配的算力底座不只是单一产品,而是包含一套从中心到边缘的产品线矩阵:面向大规模集群的超节点、FusionServer服务器、TokenBox ™本地AI超级工作站、FusionXpark系列, FusionXtation X3系列等等。
其中,超聚变FusionServer“无极”架构,正是超聚变为Token时代打造的算力底座。过去x86与ARM两套生态各成体系,服务器厂商往往要分别开发产品线,零件、模具、测试重复投入。无极架构用模块化设计把两套生态统一到同一底座上:CPU换模块,底盘、散热、电源、管理等部件尽量共用,部件共享率超过90%,新品开发不再从零开始。
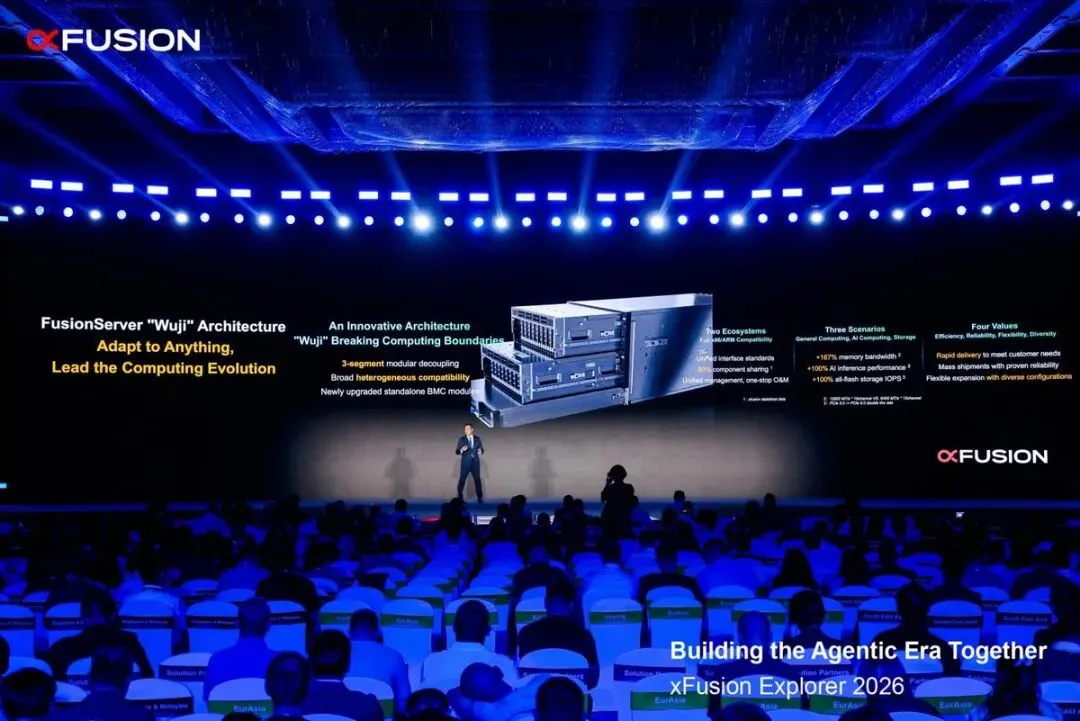
基于该架构的新一代V9双平台服务器——超聚变FusionServer 2158H V9 & FusionServer 2258H V9,分别对应单路与双路形态,均搭载AMD新一代Venice SP7平台(Zen6 架构,业界首款2nm工艺服务器CPU),组合起来对应不同需求。
此外,FusionOne AI还推出了TokenBox ™本地AI超级工作站,其将机房级AI基础设施和团队组织、生产场景连接起来,补齐大型数据中心集群与桌面工作站之间的算力缺口,提供模型推理、Token运营和智能体基础设施。
FusionOne AI还将企业已有AI服务器、第三方异构算力和未来新增资源统一起来,通过池化和调度确保资源利用率最大化。
再往上高效稳定的Token生产流水线。模型Benchmark追求峰值性能,但企业生产更关心的是高峰期交付的稳定性SLA、多任务并发时的响应速度以及「不出错不宕机不影响业务」的高容错率。超聚变FusionOne AI将Smart推理加速和Smart QoS组合在一起,本质上就是在解决“生产效率”和“交付秩序”这两个Token工厂运转的关键问题。
然后到了支持Day-0更新的模型层。今天模型更新速度已快到企业无法靠人工跟踪和手动替换,Google Gemini 只用了三周就迭代到3.7 Flash,价格更低、能力更强,企业如果没有一套持续的模型接入、测试和切换机制,就很难吃到模型进化带来的红利。 FusionOne AI支持Day0 ModelEver,将模型更新做成流水线,通过自动化模型监控、调优和打包,让新模型进入企业生产环境的时间尽可能缩短。
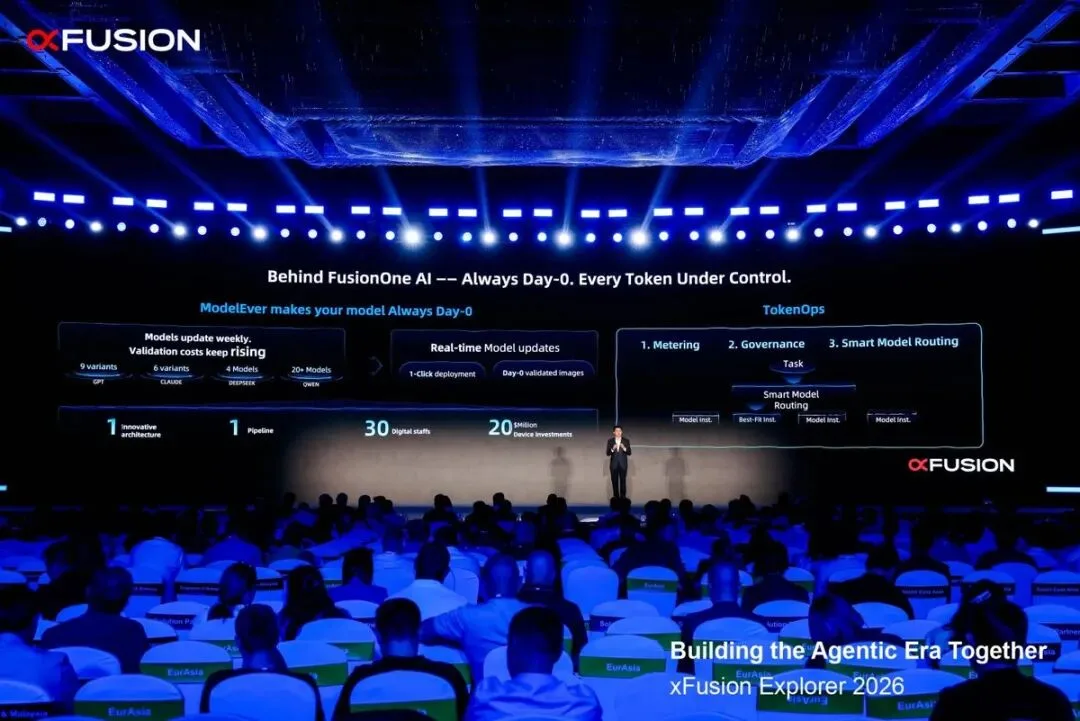
再往上,是当前企业最急需的TokenOps,也就是Token计量。
云计算Ops已是基操,只是TokenOps难度更大,要么做不到,要么统计不准不及时。Token计量不准,就治理不好;治理不好,优化就是空谈。员工用了多少Token只是第一层数据,更重要的是这些Token被谁用掉、用于什么项目、调用什么模型、产生多少推理成本、是否重复调用、是否陷入Agent循环,以及最终有没有对应的业务结果。
而超聚变FusionOne AI能做好TokenOps的基础是“自建模式”,基于此企业可将散落在模型平台、云服务、应用系统和员工账号里的数据重新组织起来,对Token进行全生命周期追踪。不只是可规避“员工烧爆Token账单”,还能确保Token实现“精准滴灌”。
最后FusionOne AI还搭建了一套“1+3+N”的AI落地生态体系,让企业可以更快地将AI给全面用起来。比如AgentCare套件提供安全保障,确保AI既快又稳地融入业务;比如还提供了丰富的上层Agent生态,涵盖AI Coding、智能体开发、AI Office、AI 短视频、金融营销风控和智能制造等。
AI应用深水区,FusionOne AI让企业实现Token自由
其实FusionOne AI并不是超聚变凭空“制造”出来的,它是其自身在AI大规模落地中沉淀出的技术、能力、方法与范式的对外溢出。
超聚变官方披露其内部已有10多个模型服务和研发场景、49个AI智能体,日均Token产出和消耗超过300亿。在大规模用AI的过程中,超聚变积累了丰富的Token治理经验。
以AI Coding这一最容易出现“超支账单”的场景为例。超聚变团队AI Coding覆盖率达到100%,人均端到端代码产出率相较两年前累计提升44%,每天消耗约62亿Token。典型Coding任务经常需要128K甚至更长的上下文,如果只是把模型和普通推理引擎直接接起来,很容易出现Prefill排队、KV Cache占用大量显存、GPU空转等问题,Token消费增加了,生产效率却未必同步增长。超聚变披露的实践中,FusionOne AI针对这类场景研发SmartKVSparse,通过智能稀疏和KV量化等技术优化长上下文推理,在其测试口径下,AI Coding生成性能实现翻倍、吞吐提升50%以上。
超聚变的实践表明:更好的Token调度、模型选择和推理架构,能够让同样的业务负载获得更高的产出,这也是FusionOne AI一脉相承的理念。所以我也更能理解,为什么FusionOne AI把超聚变自己当成“001号客户”。
今天,AI产业正在经历一个跟工业革命早期相似的阶段。
企业主最初以为只要将更多机器搬进工厂、生产效率就会得到更多提升,结果事与愿违,直到1913年,福特在汽车工厂首次引进了传送带系统及装配线(Assembly Line),将“流水线”概念引入工业生产。相较于单一机器的效率提升而言,体系优化才能真正提升全局效率:生产线设计、原材料供应、质量控制、订单排产、工人管理……一年百年后的今天,制造业依然在想方设法提升生产效率,甚至为此用上了AI和机器人。
AI也是如此。模型只是不断升级的机器,要让企业AI规模化应用高效且省、又快又好、安全可控的,必须将算力、Token、数据、Agent整合成一套稳定生产系统,也就是Token工厂。
在过去打造Token工厂对企业来说是一个高难度命题,建设难、管理经营更难。FusionOne AI通过软硬件结合的方式,助力企业建设与运营自己的Token工厂,堪称雪中送炭,其最大的突破在于:不只是解决Token供给或者应用中的一环问题,而是从建、到用、到管、到升级再到业务融入进行全链路交付。
对于企业来说,基于FusionOne AI,不只是可以获得全局最适合的Token,还能快速构建Token管理与治理体系,形成Token用量与业务价值的评判链路,形成真正意义上的Token自由。
什么是真正意义上的Token自由?不是简单堆额度,也不是一刀切限额,而是“Right tokens, at the right cost, for the right outcome(合适的Token、合适的成本、合适的产出)”,这也是所有积极拥抱AI的企业应当追求的“Token自由”理想状态。