 雷科技








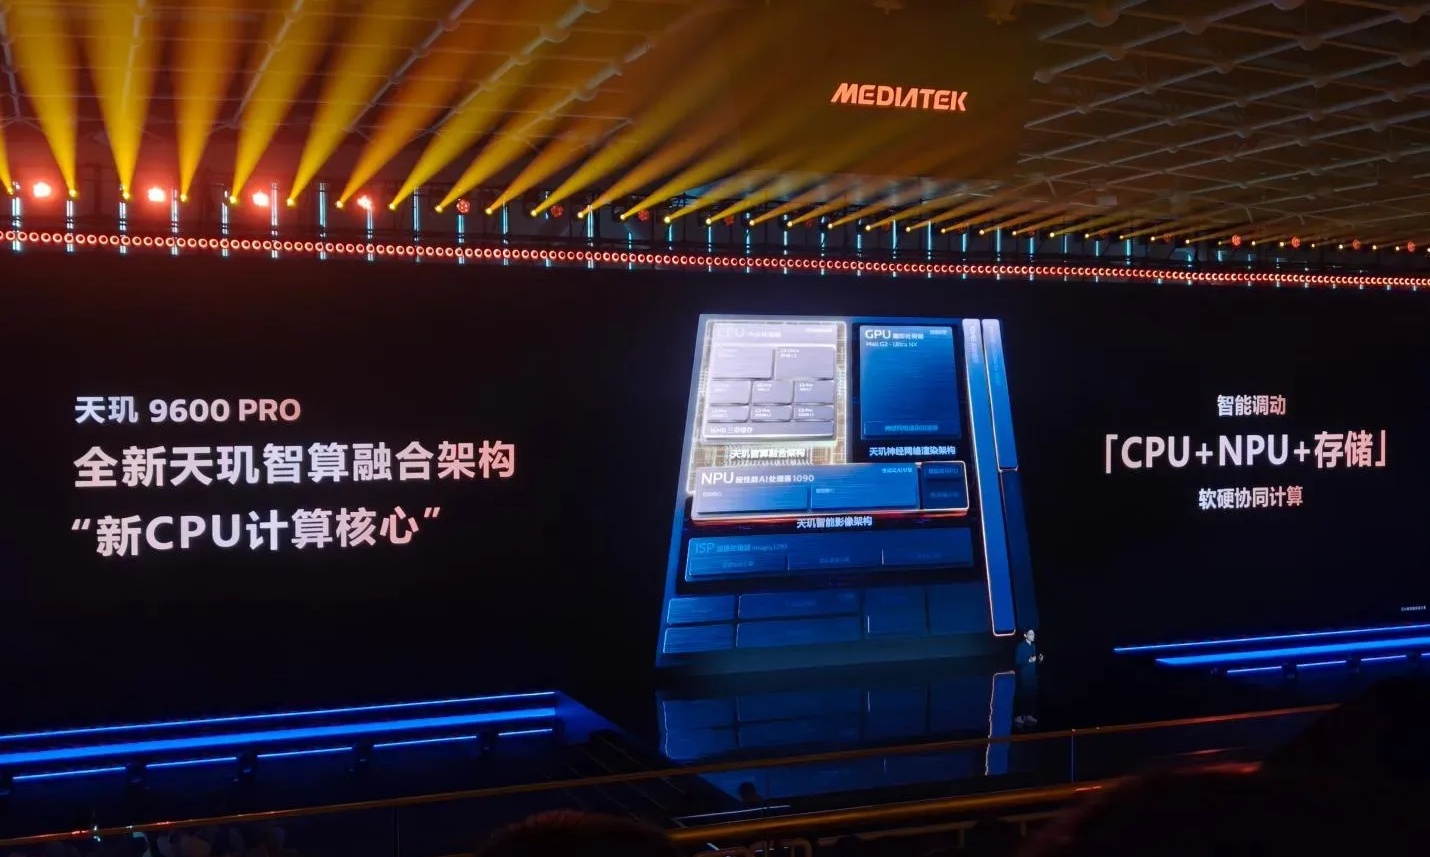

9月15日,联发科正式推出新一代天玑旗舰芯片——天玑9600 Pro,一款真正面向智能体手机的Agentic SoC。
从Claude Code到OpenClaw的爆发,Agentic AI(智能体AI)几乎就是今年AI领域最明确的一条技术主线。背后是Agent正在从根本上改变人机交互的方式,也注定「AI手机」要向「智能体手机」进化:手机要理解意图、主动感知,甚至替你执行任务,不再只是等用户「打开App」。
这场变化同时发生在OS和芯片两端。OS要把Agent组织成新的交互和服务体验,芯片则决定这些能力能否持续、流畅、高效地运行。芯片能力为OS打开新的可能,OS带来的新场景,也会反过来推动芯片变化。
所以我们看到谷歌、华为、小米,以及「新晋玩家」豆包和阶跃星辰都在往AgentOS演进,OPPO、vivo和荣耀的新一代操作系统也在向AgentOS进化。此时天玑9600 Pro的推出,则显得恰逢其时。
不只是更强的NPU,在天玑9600 Pro上,我们看到了围绕AI原生架构设计的旗舰芯片,已经驰骋在旗舰新赛道上。
Agent改变SoC,AI开启「全芯化」
先简单看下这一代的「底子」。天玑9600 Pro作为行业首批采用台积电2nm制程的移动SoC,整颗芯片塞进了超过330亿颗晶体管。
CPU继续坚持全大核路线,只不过这次变成了2+3+3:
2× C2-Ultra超大核@4.55GHz
3× C2-Pro大核@4.35GHz
3× C2-Pro大核@3.1GHz
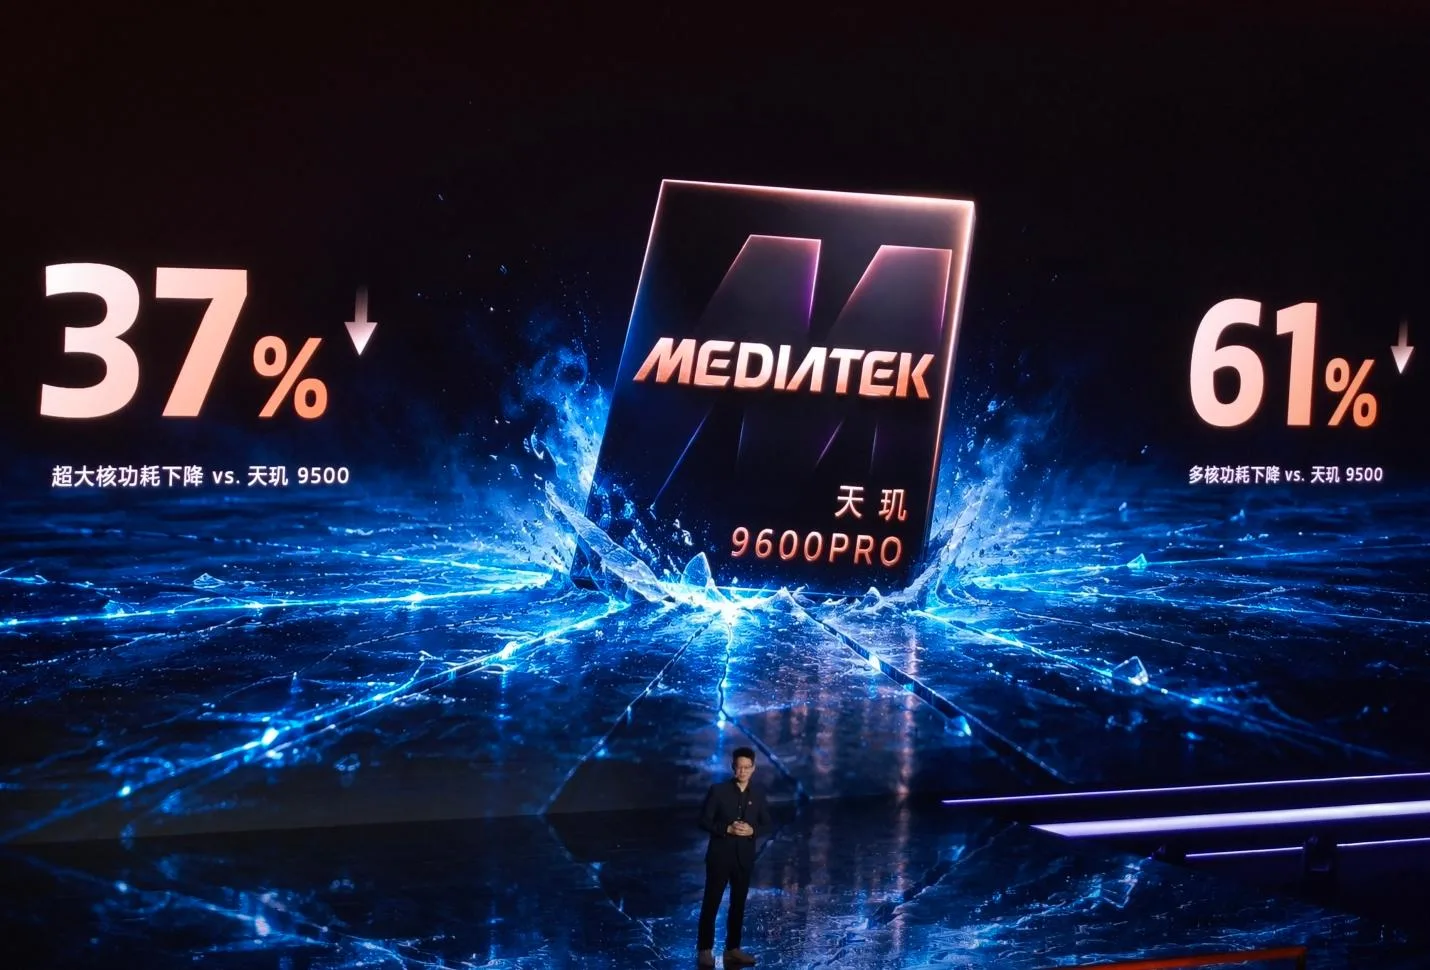
加之 L2+L3 + 系统缓存合计达到 34.5MB,其中二级缓存较天玑 9500 提升 21%,还率先支持LPDDR6和UFS 5.0。相比前代,天玑9600 Pro的超大核性能提升了17%,多核性能提升了15%,更是做到超大核功耗下降37%,多核功耗下降61%。
这不仅意味着手机可以跑得更快、更省电,在Agent时代也意味着更多余力去承接频繁的系统调用、多任务并发,以及持续发生的Agent交互。
坦白讲,这些升级已经足够让人满意,但天玑9600 Pro面向AI的升级显然不止于此。
过去我们谈手机AI,注意力很容易集中在NPU,毕竟端侧模型要跑得快,就得有更强的NPU算力。但Agent不只是大模型,不是跑一次模型就结束,一句「帮我订一张明天去上海的机票」,到最后真正完成任务,中间要经过模型推理、读取上下文、检索信息、打开应用、调用系统服务、等待结果,再重复多次推理和执行。
NPU负责端侧模型的计算,但大量应用执行、系统调用和任务编排,最终还是要落到CPU上,同时内存要留住模型和应用,电源管理还要应付一次次启动与休眠。简言之,Agent任务需要调动整个SoC,而不只是NPU。
所以AI必然要从NPU的一项能力,彻底融入整颗SoC的架构设计。
而CPU对于Agent和用户都同等重要,作用自然极其关键。天玑9600 Pro不仅在第四代全大核架构中,通过双超大核的设计面对AI重载、多任务和复杂应用负载,更是创新性设计了天玑智算融合架构,把CPU、NPU、电源和内存拉到一起,根据端侧AI任务预测接下来的算力需求,再动态调度资源。
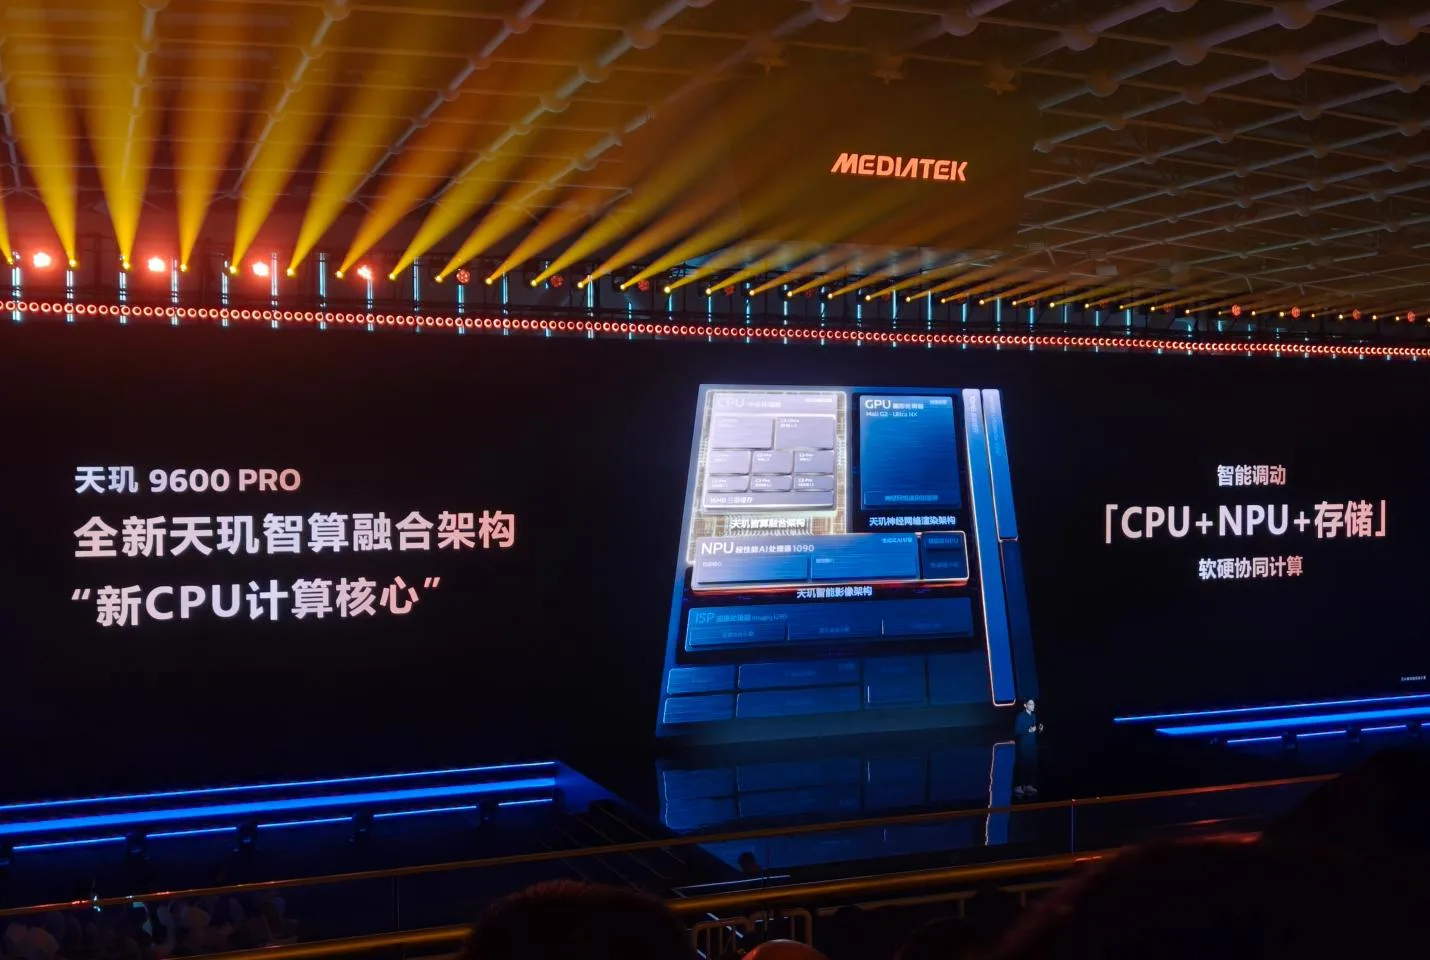
官方数据显示,在3B大语言模型测试下,出词速度提升了40%。更值得注意的是,CPU快开快关的速度,相比天玑9500提升了10倍。CPU的「随用随开」,成为智能体手机既能持续在线、又能控制功耗的关键底层能力。
此外,Agent长期存在于系统里,同时和几十个应用抢CPU、抢内存、抢功耗预算。而天玑9600 Pro除了率先支持LPDDR6和UFS 5.0外,关键的变化还在于采用了AI与App并发的「超级内存调度技术」,可以实现25个应用和一个3B大模型同时保活,大模型启动速度还能提升27%。
Agent时代,需要更强的双NPU
以「大模型+Harness」为核心,Agent端侧运行的表现,自然还是离不开NPU的算力支持,只是我们需要更加兼顾性能与能效表现的NPU。
智能体手机面对的AI负载,恰好分成了差异很大的两类。一类是环境感知、情境识别这样的轻载任务,需要长时间低功耗运行的NPU。另一类则是多模态理解、大模型推理和复杂任务执行,除了云端,也需要短时间内可以调用足够端侧AI算力的NPU。
这很矛盾。都交给一颗追求峰值性能的NPU,很难绕开功耗问题。但如果为了低功耗牺牲性能,多模态理解、大模型推理这些重载任务,又很难获得足够的端侧算力支持。所以天玑颠覆性地设计双NPU架构,在能效和性能之间找到了最佳平衡点。
第二代超能效NPU功耗相比天玑9500降低40%,让轻载AI模型Always-On可以全天候运行。超性能NPU 1090则负责更重的端侧推理,大语言模型预填充性能较天玑9500提升51%,每瓦特生成词元数提升了55%,最高可以在端侧运行30B的MoE大模型。
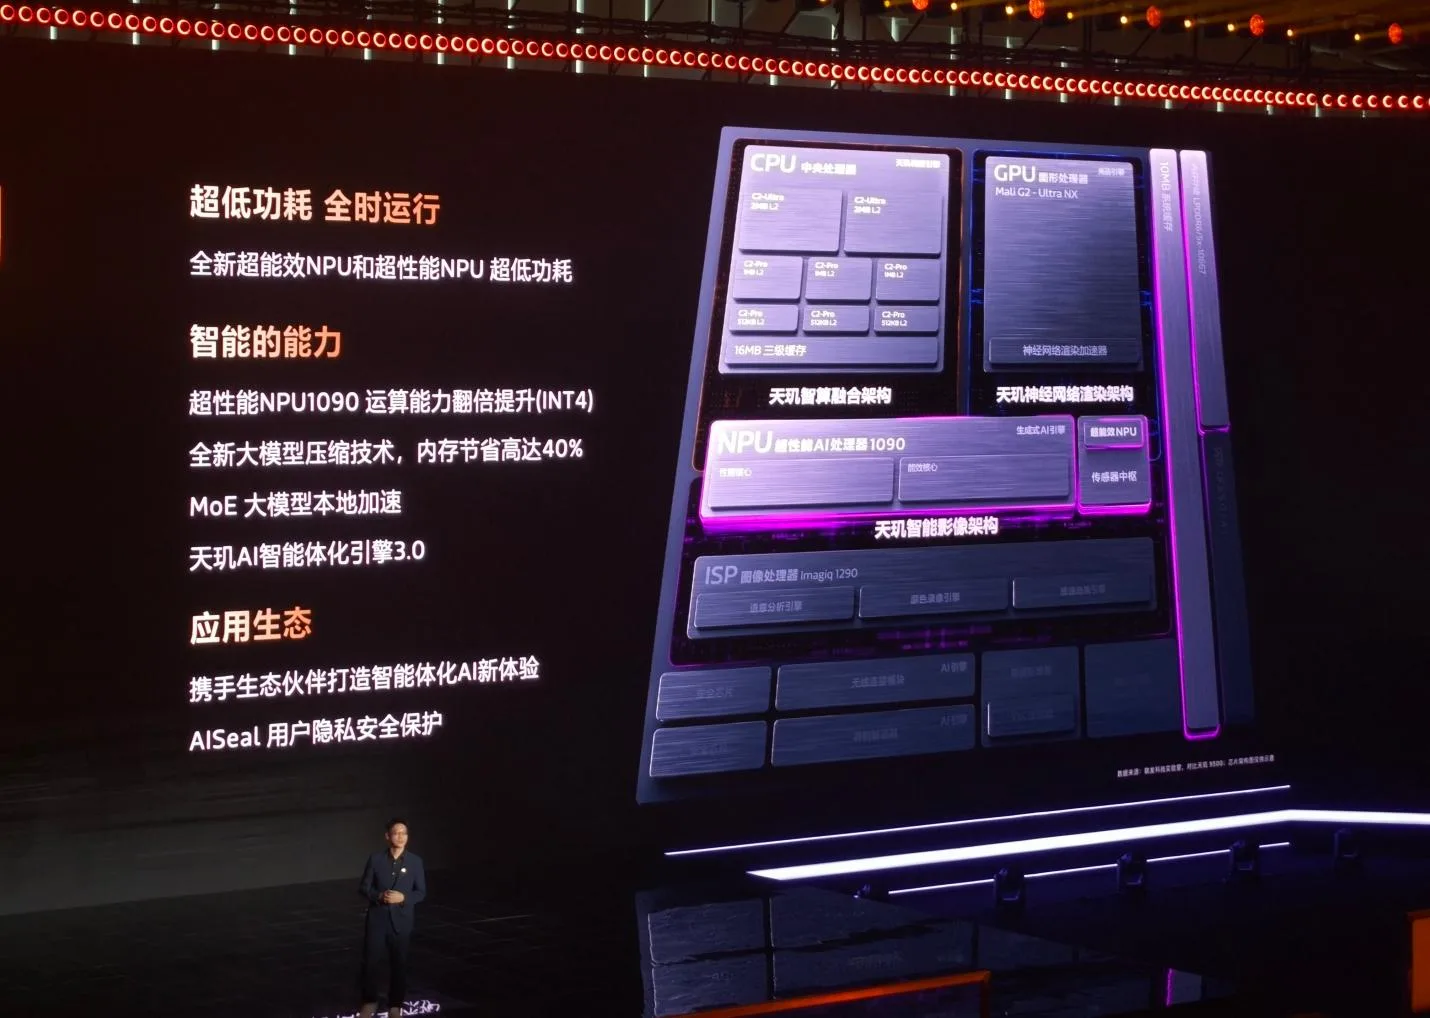
正是有了强悍的双NPU,联发科让Agent可以用更低的计算开销和功耗,持续理解手机与用户周围正在发生什么,再配合前面提到的「天玑智算融合架构」,在手机上实现真正的「AI个人助手」体验。
简单来说,第二代超能效NPU「一直醒着」,始终关注环境和用户,超性能NPU 1090「认真思考」,在AI需要时全力计算。
比如与OPPO合作,让小布助手可以主动识别用户的「要紧事」并及时提醒。而与阶跃星辰的合作,则让手机可以进一步理解用户意图,提供更主动的智能体服务。
双NPU架构的价值,也就在这里。Agent既要长期在线,也要在需要的时候完成更复杂的推理,两种状态各自交给更合适的算力,才有可能兼顾体验和功耗。
游戏、影像和通信,AI的全链路渗透
当然,让AI真正融入整颗SoC,也包括GPU、ISP乃至通信等计算链路。
尤其是在游戏方面,英伟达、苹果在PC上都引入了神经网络渲染技术,基本思路就是让AI直接参与游戏画面渲染,降低传统GPU负担,来实现更强大的游戏性能。
手机的芯片面积、功耗和散热空间更是有限,继续堆GPU规模、拉高频率,移动游戏迟早会撞上一堵墙。
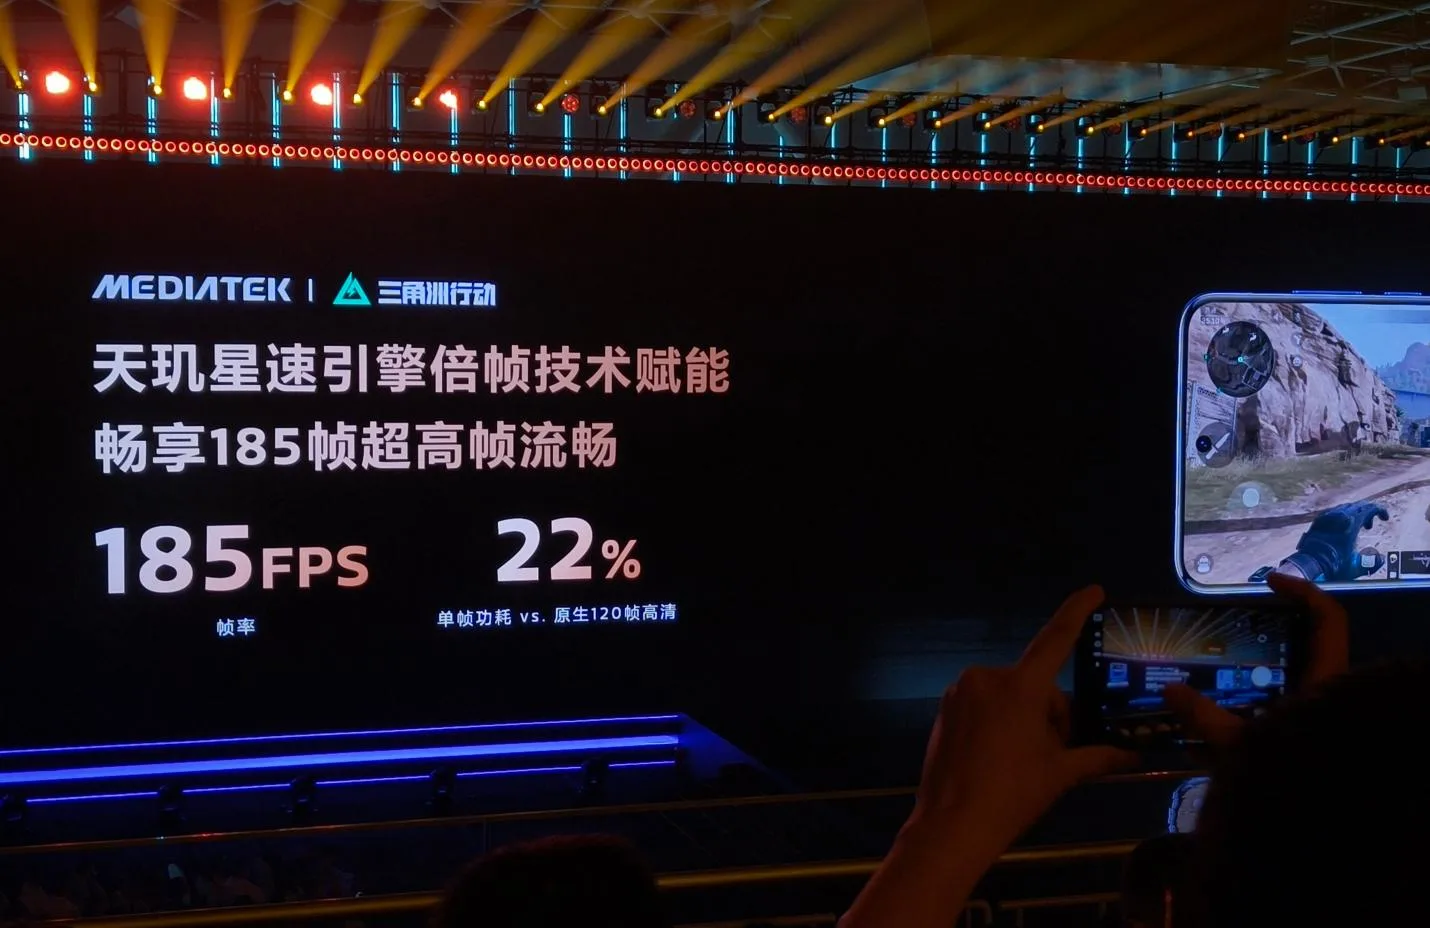
而天玑9600 Pro采用了新一代G2-Ultra NX GPU,3DMark Steel Nomad Light峰值在同功耗下性能提升了18%,功耗相较天玑9500下降了24%,在《三角洲行动》中能以原生185fps(平均)满帧流畅游玩;在重载游戏《明日方舟:终末地》中也可以做到平均59fps,且相同帧率下功耗相较天玑9500下降30%。
更重要的是联发科把神经网络渲染技术真正带到了移动端,在天玑神经网络渲染架构下,通过GPU与NPU协同实现游戏画面的渲染。实际来看,面对《无限暖暖》这样的重载游戏,也可以从540P实时超分至1080P。
而且神经网络开始替GPU完成一部分工作,画质得以大大提升的同时,功耗也能降下来。在天玑倍帧技术4.0加持下,天玑9600 Pro游戏场景的整体功耗较天玑9500可以降低20%。
比如在极重载狩猎共斗手游中,将帧数从60fps提升到90fps,单帧功耗却能相较天玑9500降低21%。同时,185fps方案相较原生120fps,单帧功耗相较天玑9500下降22%。
对手机来说,这条路甚至可能比单纯提高百分之十几的GPU性能更重要。
而到了天玑智能影像架构,AI也在进一步融入ISP的计算流程。全景深计算光学影像会借助NPU完成多帧计算,让前景和后景同时保持清晰。AI语义分析引擎则会先理解画面,再让ISP分区处理色彩和影调。
过去ISP更多是在处理像素,现在它还要先「看懂」像素。今年天玑还特别支持 4K 240fps 的录像功能,这将成为旗舰手机对抗新iPhone录像的杀手锏。
天玑AI通信开放平台甚至允许OEM厂商使用自己的模型,参与蜂窝选网、Wi-Fi和定位决策。联发科提供底层能力,厂商再用自己的数据和场景继续调校,把AI变成更稳定的连接体验。
从Agent到游戏、影像和通信,AI正在进入SoC原本的计算逻辑。所谓「AI原生」,也应该从整颗芯片如何被重新组织来理解。
写在最后
回头看,从更早推动端侧大模型,到天玑9400把Agent能力逐步带进NPU,再到天玑9500率先用双NPU解决高性能与Always-On之间的矛盾,联发科可能在很早就预见:当AI真正进入手机,最终一定不会只停留在一个聊天框、一颗NPU。
比起竞品单独的性能提升和「冰冷」的峰值跑分数值,天玑9600 Pro在日常真实使用场景下的能效曲线更加漂亮,而更大的变化在于,AI从NPU进入整颗SoC,让原本相对独立的计算单元,围绕AI变得更加一体化、更加强大。面对智能体AI发展浪潮,只有面向AI新时代设计的融合计算架构才能真正助推端侧体验落地。
说到底,智能体手机真正需要考察的,是整颗SoC能否承载持续、碎片化又不断变化的AI任务,以及芯片能否和OS、模型、应用共同完成一个任务。
最终落到用户身上。Agent可以更长时间待在后台,需要思考时又有足够的算力。游戏可以借助神经网络提高画质、降低功耗,相机和通信也能更早判断环境,主动做出调整。
用户未必知道背后调用了哪颗NPU,但应该能感受到手机更懂自己,同时依旧流畅、稳定,也不至于因为AI而带来电量焦虑。
在这个意义上,天玑9600 Pro给出的,是一套面向智能体手机的新底座,也是今天打造全新一代智能体手机最好的硬件底座。